Транзакции обычно вспоминают в момент, когда что-то уже сломалось.
- Два пользователя одновременно купили последний товар.
- Два воркера взяли одну и ту же задачу.
- Баланс списался два раза.
- Номер в отеле забронировали дважды.
- Проверка “если записи нет – создать” внезапно создала дубликаты.
- Отчёт внутри одной операции начал показывать разные данные.
На первый взгляд кажется, что проблема в плохом SQL, невнимательности или “ну кто же знал, что два запроса придут одновременно”. На практике часто причина проще: разработчик использовал транзакцию, но не понимал, что именно гарантирует её уровень изоляции.
Транзакция – это не просто BEGIN, COMMIT и чувство безопасности. Важна не только атомарность, но и изоляция: какие данные видит транзакция, как она ведёт себя при параллельных изменениях и какие аномалии может пропустить.
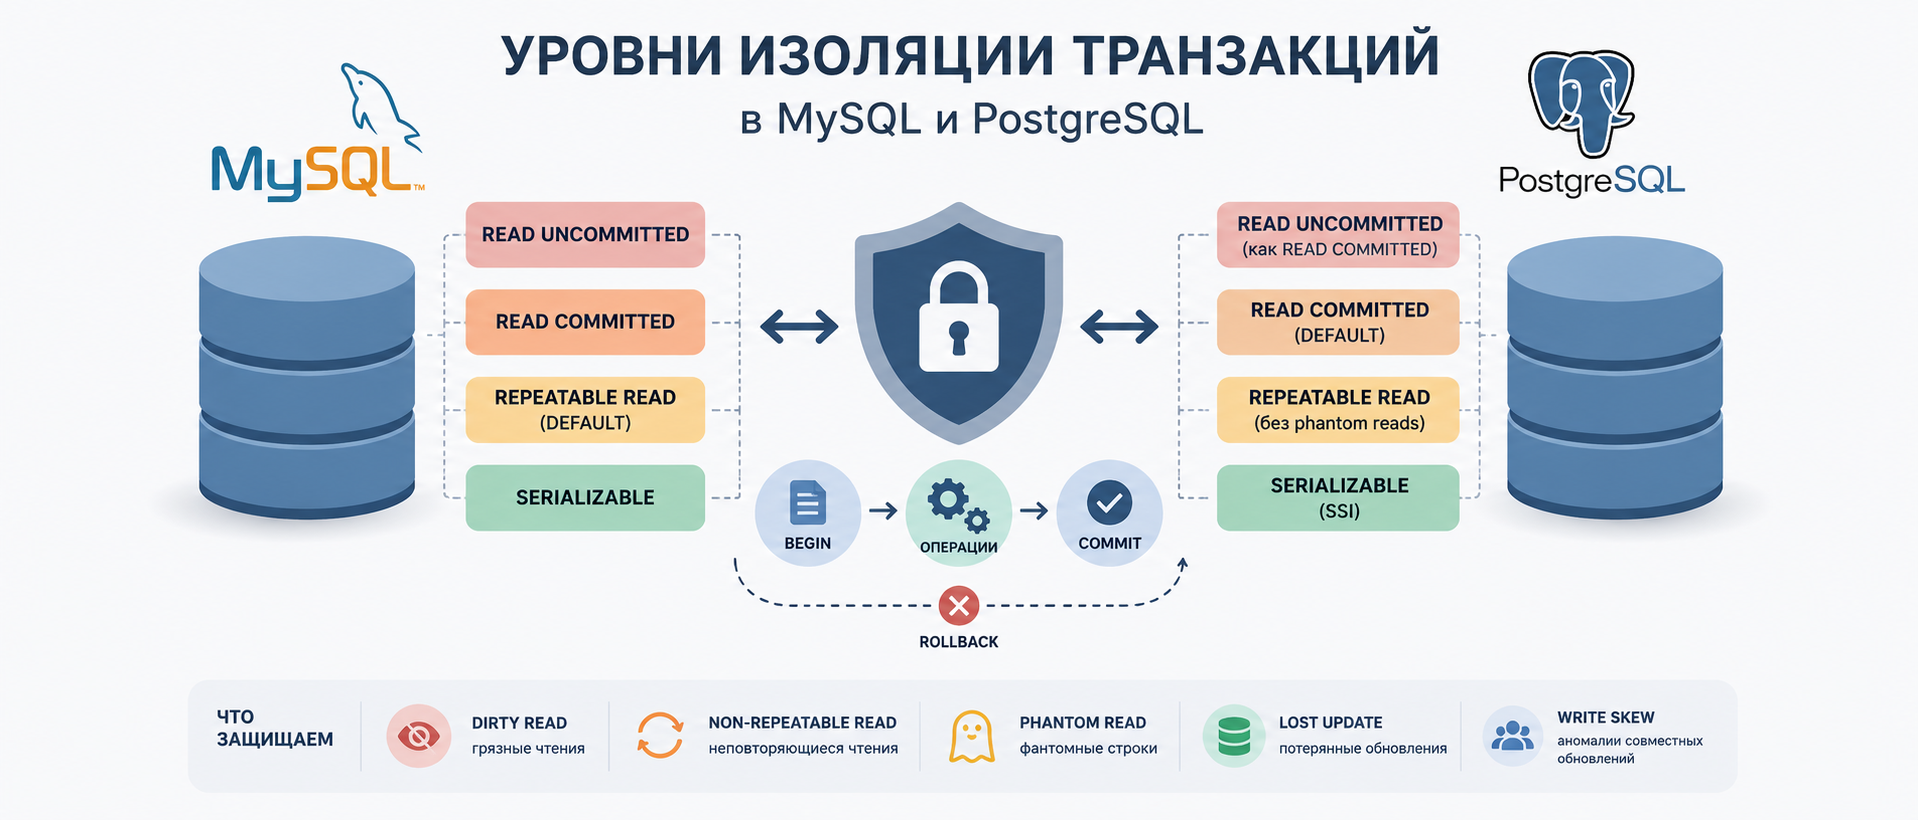
В этой статье разберём уровни изоляции транзакций в MySQL и PostgreSQL: READ UNCOMMITTED, READ COMMITTED, REPEATABLE READ, SERIALIZABLE, реальные аномалии, отличия между СУБД, SELECT FOR UPDATE, constraints и практические сценарии.
- Коротко
- Что такое транзакция
- Что такое уровень изоляции
- Какие аномалии бывают
- Dirty read
- Non-repeatable read
- Phantom read
- Lost update
- Write skew
- Уровни изоляции SQL
- READ UNCOMMITTED
- READ COMMITTED
- REPEATABLE READ
- SERIALIZABLE
- MySQL и PostgreSQL: названия одинаковые, поведение не всегда одинаковое
- PostgreSQL
- MySQL / InnoDB
- Уровень изоляции не заменяет SELECT FOR UPDATE
- Уровень изоляции не заменяет constraints
- Практический сценарий 1. Списание баланса
- Практический сценарий 2. Бронирование номера
- Практический сценарий 3. Воркеры берут задачи
- Практический сценарий 4. Отчёт
- Практический сценарий 5. Если нет записи – вставить
- Как выбирать уровень изоляции
- Транзакции в application layer
- Retry: deadlock и serialization failure
- Частые ошибки разработчиков
- 1. Держать транзакцию слишком долго
- 2. Делать HTTP-запрос внутри транзакции
- 3. Проверять уникальность только в коде
- 4. Думать, чтоREPEATABLE READрешает всё
- 5. ИспользоватьSERIALIZABLEбез retry
- 6. Путать snapshot и lock
- 7. Не иметь индексов под условия блокировки
- 8. Делать “SELECT, потом INSERT” без constraint
- 9. Игнорировать отличия MySQL и PostgreSQL
- 10. Гасить исключения транзакций
- Итог
Коротко
Если нужно быстро:
- PostgreSQL по умолчанию использует
READ COMMITTED. - MySQL/InnoDB по умолчанию использует
REPEATABLE READ. READ UNCOMMITTEDпочти никогда не нужен в прикладном backend-коде.READ COMMITTEDхорошо подходит для большинства коротких CRUD-операций.REPEATABLE READдаёт стабильный снимок данных внутри транзакции.SERIALIZABLEсамый строгий уровень, но требует готовности к конфликтам и retry.- Уровень изоляции не заменяет
SELECT FOR UPDATE. - Уровень изоляции не заменяет unique index, foreign key и другие constraints.
- MySQL и PostgreSQL используют одинаковые названия уровней, но детали поведения отличаются.
- Для изменения денег, остатков, бронирований и очередей задач обычно нужны явные блокировки или ограничения на уровне БД.
Главная мысль:
Уровень изоляции определяет не “насколько транзакция хорошая”, а какие конкурентные аномалии база может допустить ради производительности.
Что такое транзакция
Транзакция – это группа операций, которые должны выполниться как единое целое.
Пример:
BEGIN;

UPDATE accounts
SET balance = balance - 100
WHERE id = 1;

UPDATE accounts
SET balance = balance + 100
WHERE id = 2;

COMMIT;
Если всё хорошо – изменения фиксируются через COMMIT.
Если что-то пошло не так – изменения откатываются через ROLLBACK.
BEGIN;

UPDATE accounts
SET balance = balance - 100
WHERE id = 1;

-- что-то сломалось

ROLLBACK;
Чаще всего транзакции объясняют через ACID:
- Atomicity – всё или ничего;
- Consistency – данные остаются в допустимом состоянии;
- Isolation – параллельные транзакции не должны ломать друг друга;
- Durability – после commit данные не должны исчезнуть.
В этой статье нас интересует буква I – Isolation.
Именно изоляция отвечает за то, что происходит, когда несколько транзакций работают одновременно.
Что такое уровень изоляции
Уровень изоляции определяет, какие изменения других транзакций видит текущая транзакция.
Например:
BEGIN;

SELECT balance
FROM accounts
WHERE id = 1;

-- в это время другая транзакция изменила balance и сделала COMMIT

SELECT balance
FROM accounts
WHERE id = 1;

COMMIT;
Вопрос:
- второй
SELECTувидит старое значение; - или новое;
- или будет ждать;
- или транзакция упадёт с ошибкой сериализации.
Ответ зависит от:
- уровня изоляции;
- конкретной СУБД;
- типа запроса;
- наличия блокировок;
- индексов;
- constraints;
- того, читаем мы данные или собираемся их менять.
Именно поэтому фраза “мы же всё завернули в транзакцию” сама по себе ничего не гарантирует. Транзакция без понимания изоляции иногда просто красиво оформляет race condition.
Какие аномалии бывают
Перед уровнями изоляции нужно понять, от каких проблем они защищают.
Dirty read
Dirty read – это чтение незакоммиченных данных другой транзакции.
Пример:
- Транзакция
T1изменила баланс. - Транзакция
T2прочитала этот новый баланс. T1сделалаROLLBACK.- Получается,
T2работала с данными, которых в базе никогда не было.
Схема:
T1: BEGIN
T1: UPDATE accounts SET balance = 0 WHERE id = 1

T2: SELECT balance FROM accounts WHERE id = 1
T2: увидела balance = 0

T1: ROLLBACK
Это грязное чтение.
В нормальном прикладном коде такое почти никогда не нужно.
Non-repeatable read
Non-repeatable read – это ситуация, когда один и тот же запрос внутри одной транзакции возвращает разные значения.
Пример:
BEGIN;

SELECT balance
FROM accounts
WHERE id = 1;

-- получили 1000

-- другая транзакция изменила balance на 500 и сделала COMMIT

SELECT balance
FROM accounts
WHERE id = 1;

-- получили 500

COMMIT;
Первый и второй SELECT вернули разные данные.
Иногда это нормально. Иногда это ломает бизнес-логику.
Phantom read
Phantom read – это ситуация, когда повторный запрос по условию возвращает новые строки.
Пример с бронированием:
BEGIN;

SELECT *
FROM bookings
WHERE room_id = 10
  AND date_from < '2026-06-10'
  AND date_to > '2026-06-01';

-- строк нет

-- другая транзакция вставила бронь на эти даты и сделала COMMIT

SELECT *
FROM bookings
WHERE room_id = 10
  AND date_from < '2026-06-10'
  AND date_to > '2026-06-01';

-- появилась новая строка

COMMIT;
Строка появилась как фантом. Её не было в первом запросе, но она есть во втором.
Lost update
Lost update – это потерянное обновление.
Пример:
- Две транзакции прочитали баланс
1000. - Первая списала
100. - Вторая списала
200. - Обе записали результат.
- Одно изменение перетёрло другое.
Плохо:
T1 читает balance = 1000
T2 читает balance = 1000

T1 пишет balance = 900
T2 пишет balance = 800

Итог: 800
А должно быть: 700
Это классический баг при работе с балансами, остатками, счётчиками и лимитами.
Write skew
Write skew сложнее.
Это ситуация, когда две транзакции читают общее состояние, каждая по отдельности принимает допустимое решение, но вместе они нарушают инвариант.
Пример:
- в больнице должен быть минимум один врач на дежурстве;
- есть два врача;
- оба одновременно снимаются с дежурства;
- каждый видит, что второй ещё на смене;
- обе транзакции коммитятся;
- в итоге врачей на смене не осталось.
С точки зрения каждой транзакции всё было логично. С точки зрения системы – инвариант сломан.
Такие ошибки особенно неприятны, потому что код выглядит правильным.
Уровни изоляции SQL
Классически выделяют четыре уровня:
| Уровень | Что даёт | Что может пропустить |
|---|---|---|
READ UNCOMMITTED | почти нет изоляции | dirty reads и другие аномалии |
READ COMMITTED | видим только закоммиченные данные | non-repeatable reads, phantom reads |
REPEATABLE READ | стабильный снимок данных внутри транзакции | зависит от СУБД и типа операции |
SERIALIZABLE | результат как при последовательном выполнении | меньше конкурентность, возможны retries |
На бумаге всё выглядит просто. В реальных MySQL и PostgreSQL начинаются нюансы.
READ UNCOMMITTED
READ UNCOMMITTED – самый слабый уровень изоляции.
Он допускает чтение незакоммиченных данных другой транзакции.
Пример:
SET TRANSACTION ISOLATION LEVEL READ UNCOMMITTED;

BEGIN;

SELECT balance
FROM accounts
WHERE id = 1;

COMMIT;
Теоретически такая транзакция может увидеть данные, которые другая транзакция ещё не закоммитила.
Почему это опасно:
- данные могут быть откатаны;
- приложение может принять решение на основе несуществующего состояния;
- отчёты могут показывать мусор;
- бизнес-логика становится ненадёжной.
В PostgreSQL этот уровень фактически работает как READ COMMITTED. То есть dirty reads PostgreSQL не допускает даже при READ UNCOMMITTED.
В MySQL/InnoDB уровень доступен, но в прикладном backend-коде его почти всегда лучше избегать.
Где может пригодиться:
- грубая диагностика;
- экспериментальные запросы;
- ситуации, где грязные данные допустимы.
Для нормального приложения правило простое:
READ UNCOMMITTED лучше считать запрещённым уровнем, если у вас нет очень конкретной причины его использовать.
READ COMMITTED
READ COMMITTED означает: транзакция видит только данные, которые уже были закоммичены.
Dirty reads на этом уровне не допускаются.
Но каждый запрос внутри транзакции может видеть новый снимок данных.
Пример:
BEGIN ISOLATION LEVEL READ COMMITTED;

SELECT balance
FROM accounts
WHERE id = 1;

-- другая транзакция изменила balance и сделала COMMIT

SELECT balance
FROM accounts
WHERE id = 1;

COMMIT;
Второй SELECT может увидеть новое значение.
Это нормально для READ COMMITTED.
Плюсы:
- хороший уровень для большинства коротких операций;
- меньше конфликтов;
- меньше долгих блокировок;
- поведение обычно интуитивно для CRUD;
- дефолт в PostgreSQL.
Минусы:
- повторное чтение может дать другой результат;
- нельзя рассчитывать на стабильный snapshot внутри транзакции;
- возможны phantom reads;
- для конкурентных изменений всё равно нужны блокировки или constraints.
Когда подходит:
- обычный CRUD;
- короткие транзакции;
- операции, где не важно повторное чтение одного и того же значения;
- сценарии, где конфликтующие строки явно блокируются через
FOR UPDATE.
Пример хорошего использования:
BEGIN;

SELECT *
FROM accounts
WHERE id = 1
FOR UPDATE;

UPDATE accounts
SET balance = balance - 100
WHERE id = 1;

COMMIT;
Здесь важен не только уровень READ COMMITTED, но и FOR UPDATE.
REPEATABLE READ
REPEATABLE READ даёт транзакции стабильный снимок данных.
Если транзакция прочитала строку, повторное чтение этой строки внутри той же транзакции обычно возвращает то же значение, даже если другая транзакция уже изменила данные и сделала COMMIT.
Пример:
BEGIN ISOLATION LEVEL REPEATABLE READ;

SELECT balance
FROM accounts
WHERE id = 1;

-- другая транзакция изменила balance и сделала COMMIT

SELECT balance
FROM accounts
WHERE id = 1;

COMMIT;
На REPEATABLE READ текущая транзакция продолжает видеть старое значение.
Плюсы:
- стабильное представление данных;
- хорошо для отчётов;
- удобно для сложных чтений;
- меньше сюрпризов при повторном
SELECT; - дефолт в MySQL/InnoDB.
Минусы:
- транзакция может не видеть свежие изменения;
- можно ошибочно думать, что этот уровень решает все race conditions;
- для изменений всё равно нужны явные блокировки;
- поведение MySQL и PostgreSQL отличается деталями.
В PostgreSQL REPEATABLE READ работает сильнее, чем многие ожидают: он не допускает phantom reads.
В MySQL/InnoDB REPEATABLE READ связан с consistent reads, next-key locks и gap locks. Там важно различать обычное чтение и locking read.
Когда подходит:
- отчёты в рамках одного snapshot;
- операции, где важно видеть стабильную картину;
- сложные read-only транзакции;
- MySQL-проекты, которые живут на дефолтном уровне.
Но есть важное предупреждение:
REPEATABLE READ не освобождает от необходимости думать о блокировках, индексах и constraints.
SERIALIZABLE
SERIALIZABLE – самый строгий уровень изоляции.
Идея такая: результат параллельных транзакций должен быть таким, как будто они выполнились последовательно, одна за другой.
Пример:
BEGIN ISOLATION LEVEL SERIALIZABLE;

-- операции

COMMIT;
Плюсы:
- сильнейшая защита от конкурентных аномалий;
- проще рассуждать о корректности;
- полезно для сложных инвариантов;
- снижает риск write skew.
Минусы:
- больше конфликтов;
- ниже конкурентность;
- транзакции могут падать с ошибками сериализации;
- приложение должно уметь повторять транзакцию;
- нельзя просто включить и забыть.
В PostgreSQL при SERIALIZABLE возможна ошибка сериализации. Это не баг. Это способ базы сказать: “при таком параллельном выполнении я не могу гарантировать корректный последовательный результат, повтори транзакцию”.
Упрощённо:
Serialization failure - повтори транзакцию
Deadlock - повтори транзакцию или измени порядок блокировок
Когда подходит:
- сложные конкурентные инварианты;
- финансовые операции;
- критичные ограничения;
- ситуации, где проще повторить транзакцию, чем вручную расставлять блокировки;
- системы, где корректность важнее throughput.
Но использовать SERIALIZABLE как универсальную таблетку не надо. Это не волшебный режим “сделать правильно”. Это режим “больше гарантий, больше конфликтов, нужна дисциплина retry”.
MySQL и PostgreSQL: названия одинаковые, поведение не всегда одинаковое
READ COMMITTED, REPEATABLE READ, SERIALIZABLE звучат одинаково в MySQL и PostgreSQL. Но детали отличаются.
PostgreSQL
Ключевые моменты:
- дефолтный уровень –
READ COMMITTED; READ UNCOMMITTEDфактически работает какREAD COMMITTED;REPEATABLE READдаёт стабильный snapshot;REPEATABLE READв PostgreSQL не допускает phantom reads;SERIALIZABLEможет завершать транзакции ошибкой сериализации;- приложение должно уметь повторять транзакцию при serialization failure.
PostgreSQL активно использует MVCC. Читающие транзакции обычно не блокируют пишущие, а пишущие не блокируют читающих так, как это происходит в более грубых lock-based моделях.
Но это не значит, что можно не думать о конкурентности. Просто проблемы проявляются иначе.
MySQL / InnoDB
Ключевые моменты:
- InnoDB поддерживает четыре уровня изоляции;
- дефолтный уровень –
REPEATABLE READ; - обычное consistent read и locking read ведут себя по-разному;
SELECT ... FOR UPDATEиSELECT ... FOR SHAREважны для конкурентных изменений;- gap locks и next-key locks влияют на диапазонные запросы;
READ COMMITTEDможет уменьшить часть блокировок, но меняет видимость данных;SERIALIZABLEделает чтения более строгими и блокирующими.
В MySQL особенно важно понимать, какой именно запрос вы выполняете:
- обычный
SELECT; SELECT ... FOR UPDATE;UPDATE;INSERT;- запрос по индексу;
- запрос по диапазону;
- запрос без подходящего индекса.
Один и тот же уровень изоляции может вести себя очень по-разному в зависимости от этих деталей.
Уровень изоляции не заменяет SELECT FOR UPDATE
Если вы читаете строку, чтобы потом её изменить, обычного SELECT часто недостаточно.
Пример плохого сценария:
BEGIN;

SELECT balance
FROM accounts
WHERE id = 1;

-- приложение проверило, что денег хватает

UPDATE accounts
SET balance = balance - 100
WHERE id = 1;

COMMIT;
Если две транзакции одновременно сделают такой код, можно получить конфликт или потерянное обновление.
Лучше:
BEGIN;

SELECT balance
FROM accounts
WHERE id = 1
FOR UPDATE;

-- строка заблокирована для конкурентного изменения

UPDATE accounts
SET balance = balance - 100
WHERE id = 1;

COMMIT;
FOR UPDATE говорит базе:
Я не просто читаю эту строку. Я собираюсь её менять. Заблокируй её для других транзакций, которые тоже хотят менять.
В PostgreSQL и MySQL синтаксис похож:
SELECT *
FROM accounts
WHERE id = 1
FOR UPDATE;
Для задач, где несколько воркеров берут задания из таблицы, часто используют SKIP LOCKED:
SELECT *
FROM jobs
WHERE status = 'pending'
ORDER BY id
LIMIT 10
FOR UPDATE SKIP LOCKED;
Смысл:
- взять свободные задачи;
- пропустить уже заблокированные другими воркерами;
- не ждать;
- не взять одну и ту же задачу дважды.
Это типичный пример, где уровень изоляции сам по себе не решает задачу. Нужен правильный locking read.
Уровень изоляции не заменяет constraints
Иногда разработчик пытается обеспечить корректность только кодом:
$user = $userRepository->findByEmail($email);

if ($user !== null) {
    throw new EmailAlreadyTakenException();
}

$userRepository->save(
    user: new User(
        email: $email,
    ),
);
Проблема:
- две транзакции одновременно проверили email;
- обе увидели, что пользователя нет;
- обе создали пользователя;
- получили дубль.
Правильный подход:
- проверка в коде нужна для хорошего UX;
- уникальность должна быть закреплена в БД.
ALTER TABLE users
ADD CONSTRAINT users_email_unique UNIQUE (email);
После этого даже если код ошибётся, база не даст создать два одинаковых email.
То же самое с другими ограничениями:
UNIQUE;FOREIGN KEY;CHECK;NOT NULL;- exclusion constraints в PostgreSQL;
- корректные индексы.
Транзакции и уровни изоляции важны. Но constraints часто важнее.
Код может ошибиться. Constraint не устал, не отвлёкся и не уволился.
Практический сценарий 1. Списание баланса
Задача:
- есть аккаунт;
- нужно списать деньги;
- нельзя уйти в минус;
- параллельные списания не должны ломать баланс.
Плохой вариант:
SELECT balance
FROM accounts
WHERE id = 1;

-- проверили в коде

UPDATE accounts
SET balance = balance - 100
WHERE id = 1;
Лучше:
BEGIN;

SELECT balance
FROM accounts
WHERE id = 1
FOR UPDATE;

-- проверяем баланс внутри транзакции после блокировки

UPDATE accounts
SET balance = balance - 100
WHERE id = 1;

COMMIT;
Ещё лучше добавить ограничение, если бизнес запрещает отрицательный баланс:
ALTER TABLE accounts
ADD CONSTRAINT accounts_balance_non_negative
CHECK (balance >= 0);
Для MySQL и PostgreSQL идея одна:
- короткая транзакция;
- блокировка строки;
- проверка после блокировки;
- изменение;
- commit;
- retry при deadlock или serialization failure.
Практический сценарий 2. Бронирование номера
Задача:
- нельзя забронировать один номер на пересекающиеся даты;
- два пользователя могут нажать “забронировать” одновременно.
Плохой подход:
SELECT *
FROM bookings
WHERE room_id = 10
  AND date_from < '2026-06-10'
  AND date_to > '2026-06-01';

-- если строк нет, создаём бронь
Проблема: два запроса одновременно могут увидеть, что броней нет, и оба вставят новую бронь.
Что делать:
- блокировать ресурс, вокруг которого строится инвариант;
- использовать constraints, если модель позволяет;
- в PostgreSQL рассмотреть exclusion constraint для пересекающихся диапазонов;
- использовать
SERIALIZABLE, если проще обрабатывать retry; - не полагаться только на предварительный
SELECT.
Пример с блокировкой комнаты:
BEGIN;

SELECT *
FROM rooms
WHERE id = 10
FOR UPDATE;

SELECT *
FROM bookings
WHERE room_id = 10
  AND date_from < '2026-06-10'
  AND date_to > '2026-06-01';

-- если пересечений нет, вставляем бронь

COMMIT;
Это не единственный способ, но идея понятна: нужно заблокировать не только “найденные брони”, которых может не быть, а сам ресурс, за который идёт конкуренция.
Практический сценарий 3. Воркеры берут задачи
Задача:
- есть таблица задач;
- несколько воркеров берут задачи параллельно;
- одну задачу нельзя взять дважды.
Хороший паттерн:
BEGIN;

SELECT *
FROM jobs
WHERE status = 'pending'
ORDER BY id
LIMIT 1
FOR UPDATE SKIP LOCKED;

UPDATE jobs
SET status = 'processing'
WHERE id = 123;

COMMIT;
Что даёт SKIP LOCKED:
- воркер не ждёт задачу, которую уже заблокировал другой воркер;
- разные воркеры берут разные строки;
- throughput выше;
- меньше конфликтов.
Это лучше, чем пытаться решать всё на уровне приложения через “сначала SELECT, потом UPDATE без блокировки”.
Практический сценарий 4. Отчёт
Задача:
- нужно построить отчёт;
- внутри отчёта несколько запросов;
- данные должны быть согласованы между собой.
Если использовать READ COMMITTED, разные запросы внутри одной транзакции могут увидеть разные снимки данных.
Для отчёта может быть полезен REPEATABLE READ:
BEGIN ISOLATION LEVEL REPEATABLE READ READ ONLY;

SELECT ...
SELECT ...
SELECT ...

COMMIT;
Так все запросы читают стабильный snapshot.
Практический совет:
- отчёты лучше делать read-only;
- не держать транзакцию слишком долго;
- для тяжёлой аналитики использовать реплику или отдельный контур;
- не смешивать отчёт и write-операции в одной долгой транзакции.
Практический сценарий 5. Если нет записи – вставить
Задача:
- если email свободен, создать пользователя;
- если запись уже есть, не создавать дубль.
Плохой подход:
SELECT *
FROM users
WHERE email = 'test@example.com';

-- если нет строки

INSERT INTO users (email)
VALUES ('test@example.com');
Два параллельных запроса могут пройти проверку одновременно.
Правильнее:
PostgreSQL:
INSERT INTO users (email)
VALUES ('test@example.com')
ON CONFLICT (email) DO NOTHING;
MySQL:
INSERT INTO users (email)
VALUES ('test@example.com')
ON DUPLICATE KEY UPDATE email = email;
И обязательно unique index:
ALTER TABLE users
ADD CONSTRAINT users_email_unique UNIQUE (email);
Главное правило:
Если уникальность важна, она должна быть в базе. Проверка в коде может быть, но только как удобный первый слой.
Как выбирать уровень изоляции
Нет универсального уровня для всех операций.
Практическая карта:
| Сценарий | Что выбрать |
|---|---|
| Обычный CRUD | дефолтный уровень СУБД |
| Короткие операции записи | дефолт + явные блокировки при необходимости |
| Списание баланса | FOR UPDATE, constraints, retry |
| Бронирование ресурса | locks, constraints, иногда SERIALIZABLE |
| Очередь задач | FOR UPDATE SKIP LOCKED |
| Отчёт из нескольких запросов | REPEATABLE READ READ ONLY |
| Сложные инварианты | SERIALIZABLE + retry |
| Проверка уникальности | unique constraint + upsert |
| Массовая аналитика | read replica / snapshot / отдельный контур |
Для большинства приложений нормальный подход такой:
- оставить дефолтный уровень СУБД;
- держать транзакции короткими;
- явно блокировать строки, которые собираетесь менять;
- инварианты закреплять constraints;
- обрабатывать deadlocks и serialization failures;
- не делать внешние HTTP-вызовы внутри транзакции.
Транзакции в application layer
Если смотреть со стороны PHP-приложения, транзакция обычно должна жить на уровне use case или action.
Не стоит размазывать begin/commit по репозиториям так, чтобы сценарий не понимал, где начинается и заканчивается атомарная операция.
Хороший вариант – TransactionManager:
interface TransactionManager
{
    public function run(callable $callback): mixed;
}
Использование:
class PayOrderAction
{
    public function __construct(
        private readonly TransactionManager $transactionManager,
        private readonly OrderRepository $orderRepository,
    ) {
    }

    public function handle(OrderId $orderId): void
    {
        $this->transactionManager->run(function () use ($orderId): void {
            $order = $this->orderRepository->getForUpdate(
                orderId: $orderId,
            );

            $order->pay();

            $this->orderRepository->save(
                order: $order,
            );
        });
    }
}
Так видно:
- где начинается транзакция;
- какие действия входят в atomic boundary;
- где нужно повторять сценарий при deadlock;
- кто владеет транзакционной границей.
В Laravel это может быть обёртка над DB::transaction(). В Symfony – над Doctrine transaction. В framework-free проекте – над PDO.
Идея одна: транзакция должна соответствовать сценарию приложения, а не случайному методу внутри репозитория.
Retry: deadlock и serialization failure
Даже хороший код может столкнуться с конфликтами.
Типичные случаи:
- deadlock;
- serialization failure;
- lock wait timeout;
- временный конфликт при конкурентной записи.
Это не всегда баг. Иногда это нормальная цена конкурентной работы.
Для критичных сценариев нужен retry.
Упрощённый пример:
final class RetryTransactionManager
{
    public function __construct(
        private readonly TransactionManager $transactionManager,
    ) {
    }

    public function run(callable $callback, int $attempts = 3): mixed
    {
        $lastException = null;

        for ($attempt = 1; $attempt <= $attempts; $attempt++) {
            try {
                return $this->transactionManager->run(
                    callback: $callback,
                );
            } catch (DeadlockException|SerializationFailureException $exception) {
                $lastException = $exception;
            }
        }

        throw $lastException;
    }
}
Идея простая:
- не каждый exception надо повторять;
- повторять стоит только безопасные сценарии;
- операция должна быть идемпотентной или защищённой от двойных эффектов;
- внешние побочные эффекты лучше делать после commit.
И вот здесь начинается взрослая инженерия. Просто поставить SERIALIZABLE мало. Нужно ещё уметь жить с последствиями.
Частые ошибки разработчиков
1. Держать транзакцию слишком долго
Плохо:
BEGIN
запрос в базу
HTTP-запрос во внешний API
генерация PDF
отправка email
ещё запросы
COMMIT
Чем дольше транзакция, тем выше риск блокировок, конфликтов и deadlocks.
2. Делать HTTP-запрос внутри транзакции
Внешний сервис может тормозить. Всё это время база держит блокировки.
Лучше:
- сохранить данные;
- сделать commit;
- отправить событие;
- обработать внешний вызов через очередь.
3. Проверять уникальность только в коде
Плохо:
if (! $userRepository->existsByEmail($email)) {
    $userRepository->save($user);
}
Без unique index это race condition.
4. Думать, что REPEATABLE READ решает всё
Не решает.
Для write-операций часто нужны:
FOR UPDATE;- constraints;
- retry;
- правильный порядок блокировок;
- короткие транзакции.
5. Использовать SERIALIZABLE без retry
SERIALIZABLE может отклонять транзакции. Это нормально. Приложение должно уметь повторить безопасную операцию.
6. Путать snapshot и lock
То, что транзакция видит стабильный snapshot, не значит, что она заблокировала данные для изменений.
Чтение и блокировка – разные вещи.
7. Не иметь индексов под условия блокировки
Если запрос блокирует диапазон без нормального индекса, база может заблокировать больше, чем вы ожидаете.
8. Делать “SELECT, потом INSERT” без constraint
Это классика дублей.
9. Игнорировать отличия MySQL и PostgreSQL
Одинаковые названия уровней не означают одинаковое поведение во всех деталях.
10. Гасить исключения транзакций
Если транзакция упала из-за deadlock или serialization failure, это нужно обработать, а не делать вид, что всё нормально.
Итог
Уровни изоляции транзакций – это не академическая таблица из документации. Это то, что определяет поведение приложения при параллельной работе.
Главные выводы:
- транзакция сама по себе не спасает от всех race conditions;
- PostgreSQL и MySQL отличаются дефолтами и деталями поведения;
READ COMMITTEDхорош для большинства коротких операций;REPEATABLE READдаёт стабильный снимок, но не отменяет блокировки;SERIALIZABLEдаёт больше гарантий, но требует retry;SELECT FOR UPDATEнужен, когда вы читаете строку перед изменением;- constraints в базе часто важнее проверок в коде;
- транзакции должны быть короткими;
- внешние вызовы лучше не делать внутри транзакции;
- application layer должен явно владеть транзакционной границей.
Главная мысль:
Уровень изоляции – это компромисс между корректностью и конкурентностью.