- Введение
- Базовый пример проблемы
- Кто вызывает endpoint
- Имеет ли сервис право выполнять действие
- Можно ли доверять содержимому запроса
- Internal API очень быстро разрастается
- Главная ошибка
- Плохие варианты
- Один общий API key на все сервисы
- Невозможно понять источник запроса
- Невозможно ограничить права
- Компрометация одного сервиса компрометирует всё
- Ротация превращается в боль
- Доступ только по IP
- Почему IP-based security ломается
- Доверие только внутренней сети
- Передача пользовательского JWT между сервисами
- Отсутствие подписи запроса
- Главная мысль
- Модель угроз
- Подмена вызывающего сервиса
- Replay attack
- Компрометация одного сервиса
- SSRF внутри инфраструктуры
- Утечка токена
- Lateral movement внутри инфраструктуры
- Подход 1: Static API Token
- Почему этот подход всё ещё используют
- Основные проблемы
- Нет service identity
- Нет разграничения прав
- Сложная ротация
- Single point of failure
- Когда подход допустим
- Подход 2: Per-service API keys
- Структура таблицы
- Почему нельзя хранить raw token
- Middleware авторизации
- Что это даёт
- Подход 3: Scopes и permissions
- Почему scopes обязательны
- Middleware scopes
- Granular authorization
- Подход 4: Подписанные запросы
- Общая схема
- Что это даёт
- Почему это важно
- Replay protection
- Timestamp verification
- Nonce verification
- Timestamp без nonce недостаточен
- Подход 5: OAuth2 Client Credentials
- Как это работает
- Преимущества
- Недостатки
- Подход 6: mTLS
- Как это выглядит
- Плюсы
- Минусы
- Практическая архитектура для Laravel
- Базовые компоненты
- ServiceAuthenticator
- SignatureVerifier
- Audit logging
- Ротация ключей
- Типичная схема
- Что важно
- Дополнительно полезно
- Типичные ошибки проектирования
- Один токен на всё
- Internal API без authentication
- Отсутствие scopes
- Нет replay protection
- Нет audit log
- Токены живут годами
- Internal endpoints доступны извне
- Минимальный production-ready вариант
- Когда что выбирать
- Финальный вывод
Введение
Когда разработчики начинают строить микросервисную архитектуру, вопрос авторизации между сервисами обычно решается в стиле:
- это же внутренняя сеть
- доступ только внутри Docker/Kubernetes
- ну мы же доверяем своим сервисам
- используем общий API key
Проблема в том, что микросервисы очень быстро превращают инфраструктуру в распределённую систему с десятками точек входа, фоновых обработчиков, очередей, callback’ов и внутренних API.
Именно в этот момент появляется главный вопрос:
Как сервис доказывает, что он действительно имеет право выполнять запрос?
Это уже не пользовательская авторизация.
Здесь нет формы логина, cookie или JWT пользователя в браузере.
Здесь один backend-сервис вызывает другой backend-сервис:
Ordersсоздаёт платёж вBilling;Billingотправляет событие вNotifications;GatewayвызываетUsers;Analyticsчитает данные изPayments.
И каждый такой запрос должен отвечать минимум на четыре вопроса:
- Кто вызывает endpoint
- Можно ли этому сервису вызывать endpoint
- Можно ли выполнять конкретное действие
- Не был ли запрос подделан или повторён
Во многих проектах эта задача решается крайне примитивно:
Authorization: Bearer super-secret-token
Один токен на всю инфраструктуру.
Один секрет для всех сервисов.
Без scopes.
Без ротации.
Без аудита.
Без проверки подписи.
До первого инцидента это кажется «простым решением». После первого инцидента выясняется, что:
- невозможно понять, кто именно сделал запрос;
- невозможно ограничить доступ конкретному сервису;
- невозможно безопасно отозвать токен;
- компрометация одного сервиса компрометирует всю систему.
Особенно болезненно это проявляется в системах:
- с платежами;
- webhook’ами;
- внутренними callback’ами;
- асинхронной обработкой;
- очередями;
- административными API;
- multi-tenant архитектурой.
Важно понимать:
Internal API — это такой же attack surface, как и публичный API.
Современная backend-архитектура давно ушла от модели:
внутренняя сеть = безопасная сеть
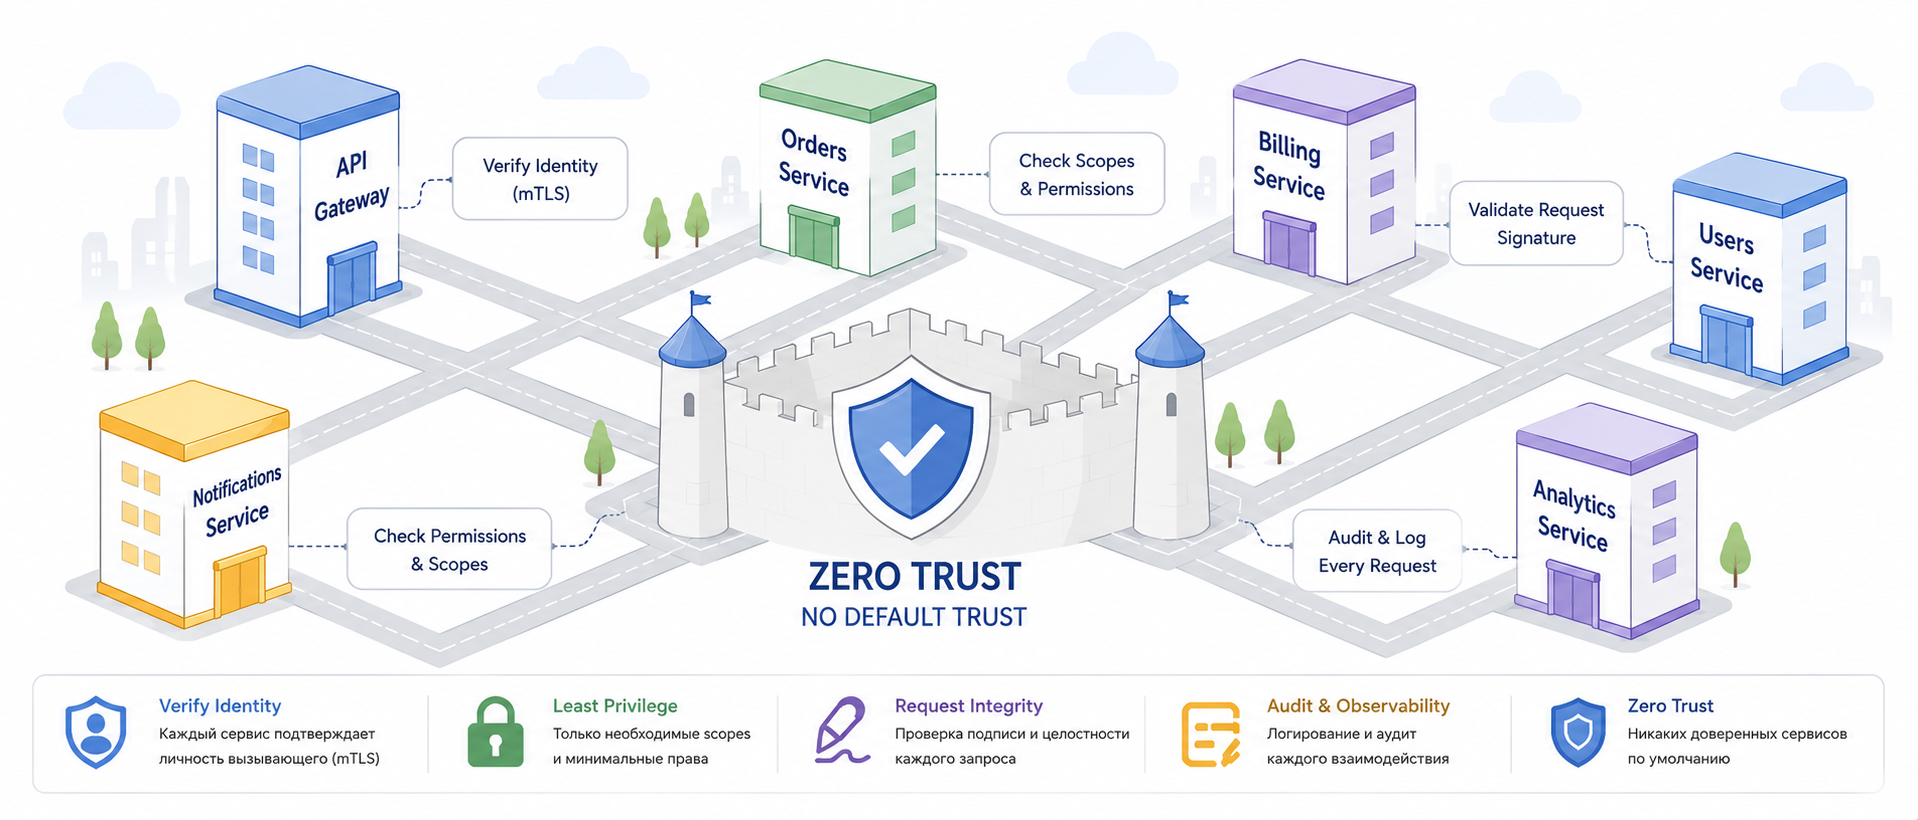
Даже внутри Kubernetes-кластера или Docker network сервис не должен получать доверие «по факту существования».
Zero Trust подход постепенно становится стандартом даже для внутренних взаимодействий.
В этой статье разберём:
- какие существуют подходы к авторизации между микросервисами
- почему простые схемы часто опасны
- как реализовать service-to-service авторизацию в Laravel
- как защищаться от replay attack
- когда достаточно API key, а когда нужен OAuth2 или mTLS
- как выглядит production-ready архитектура для internal API
Базовый пример проблемы
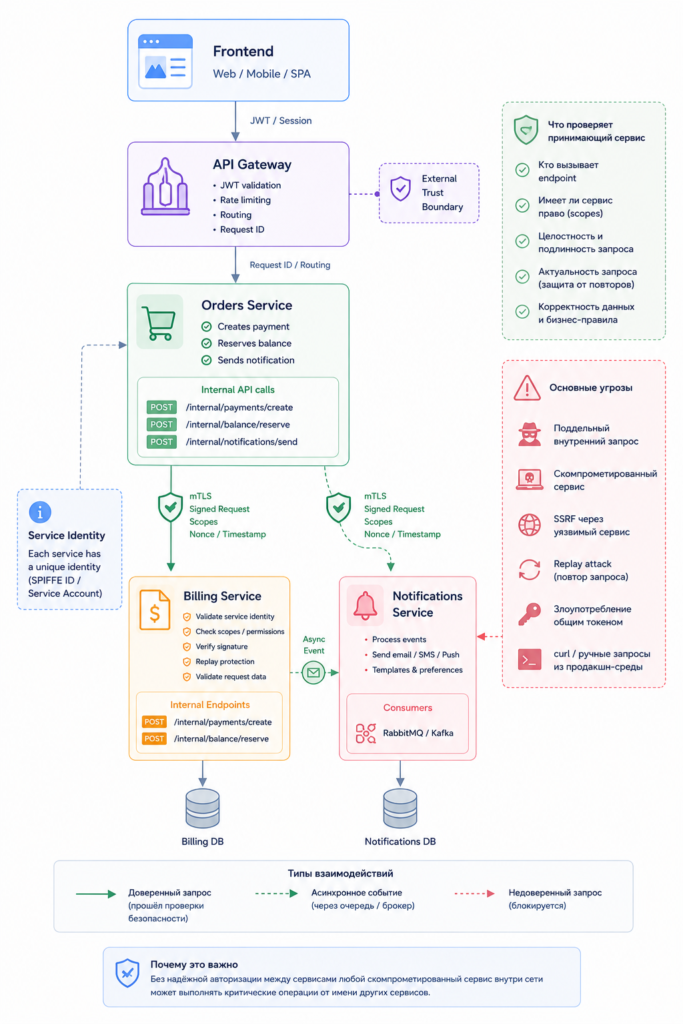
Представим типичную микросервисную схему:
Frontend
    ↓
API Gateway
    ↓
Orders Service
    ↓
Billing Service
    ↓
Notifications Service
Пользователь создаёт заказ.
Orders Service должен:
- создать платёж;
- зарезервировать баланс;
- инициировать отправку уведомления.
Для этого сервис начинает вызывать внутренние endpoint’ы других сервисов.
Например:
POST /internal/payments/create
POST /internal/balance/reserve
POST /internal/notifications/send
На первый взгляд кажется, что всё просто.
Сервисы находятся внутри одной инфраструктуры.
Можно вызывать друг друга напрямую.
Но очень быстро появляются фундаментальные вопросы безопасности.
Кто вызывает endpoint
Billing Service получает запрос:
POST /internal/payments/create
Как понять:
- это действительно
Orders Service; - это другой внутренний сервис;
- это случайный контейнер внутри сети;
- это SSRF-атака через уязвимый сервис;
- это разработчик вручную отправил curl из production-контейнера.
Если сервис доверяет любому запросу из внутренней сети — это уже проблема.
Имеет ли сервис право выполнять действие
Даже если запрос пришёл от настоящего Orders Service, возникает следующий вопрос:
Можно ли ему вызывать именно этот endpoint?
Например:
Ordersможет создавать платежи;Analyticsне должен создавать платежи;Notificationsвообще не должен иметь доступ к billing API.
Если все сервисы используют общий internal token, разграничения прав фактически не существует.
Любой скомпрометированный сервис получает доступ ко всей инфраструктуре.
Можно ли доверять содержимому запроса
Даже при наличии API key остаётся проблема подделки данных.
Например:
{
  "user_id": 1,
  "amount": 100000
}
Как убедиться, что:
- тело запроса не было изменено;
- запрос не был повторно отправлен;
- злоумышленник не воспроизвёл старый запрос;
- кто-то не подменил параметры внутри сети.
Для критичных операций простой bearer token уже недостаточен.
Особенно если речь идёт о:
- платежах;
- списаниях;
- начислениях;
- изменении баланса;
- административных действиях.
Internal API очень быстро разрастается
В начале проекта обычно есть 2–3 внутренних endpoint’а.
Через год появляются:
- internal callback’и;
- webhook consumers;
- event processors;
- cron workers;
- async consumers;
- service mesh;
- Kafka/RabbitMQ consumers;
- GraphQL federation;
- background synchronization;
- межсервисные batch-операции.
Количество внутренних взаимодействий растёт быстрее, чем публичный API.
Именно поэтому service-to-service авторизация — это не «дополнительная защита», а обязательный архитектурный слой.
Главная ошибка
Самая опасная архитектурная ошибка выглядит так:
если запрос пришёл из внутренней сети — ему можно доверять
В современной инфраструктуре это неверно.
Причины:
- компрометация одного контейнера даёт доступ к другим сервисам;
- SSRF внутри инфраструктуры становится lateral movement;
- developer tools могут случайно открыть internal endpoint наружу;
- Kubernetes network policy часто настроены неполно;
- staging/dev окружения часто имеют слабую защиту;
- внутренние сервисы тоже содержат уязвимости.
Поэтому правильная модель выглядит иначе:
каждый сервис обязан доказывать свою identity
Именно вокруг этого дальше строятся:
- API keys;
- signed requests;
- scopes;
- OAuth2 Client Credentials;
- mTLS;
- service identity;
- Zero Trust архитектура.
Плохие варианты
Перед тем как разбирать production-ready подходы, важно понять одну вещь:
Большинство проблем с безопасностью internal API появляются не из-за отсутствия сложной криптографии.
Они появляются из-за ложного ощущения доверия внутри инфраструктуры.
Ниже — самые распространённые антипаттерны, которые встречаются даже в крупных проектах.
Один общий API key на все сервисы
Классическая схема:
INTERNAL_API_TOKEN=super-secret-token
Все сервисы используют один и тот же токен:
Authorization: Bearer super-secret-token
На старте проекта это кажется удобным:
- быстро внедрить;
- не нужно хранить список сервисов;
- не нужно делать scopes;
- не нужно думать о ротации.
Но дальше начинаются системные проблемы.
Невозможно понять источник запроса
Если все сервисы используют один токен, backend теряет identity вызывающего сервиса.
Нельзя определить:
- кто вызвал endpoint;
- какой сервис скомпрометирован;
- какой сервис злоупотребляет API;
- кто создаёт повышенную нагрузку.
Логи становятся бесполезными:
internal request authorized
Но кто именно его выполнил — неизвестно.
Невозможно ограничить права
Общий токен означает полное отсутствие isolation.
Например:
Analytics Service
не должен иметь возможность:
- создавать платежи;
- менять баланс;
- удалять пользователей.
Но при общем токене он технически получает тот же уровень доступа, что и Orders Service.
Фактически вся инфраструктура начинает работать по модели:
если сервис внутри сети — ему можно всё
Это нарушает базовый principle of least privilege.
Компрометация одного сервиса компрометирует всё
Это главный риск shared token architecture.
Представим:
- найден SSRF в одном сервисе;
- утёк
.envфайл; - токен попал в логи;
- произошёл RCE в debug endpoint;
- разработчик случайно отправил токен в сторонний сервис.
После этого злоумышленник получает доступ:
- ко всем internal API;
- ко всем сервисам;
- ко всем privileged endpoint’ам.
Один секрет становится single point of failure для всей платформы.
Ротация превращается в боль
Когда один токен используется десятками сервисов:
- его сложно заменить;
- нужно одновременно обновлять множество deployment’ов;
- легко получить partial rollout;
- часть сервисов начинает падать;
- rollback становится опасным.
В результате токен не ротируется годами.
А любой секрет, который не ротируется годами, однажды обязательно утечёт.
Доступ только по IP
Следующий популярный подход:
allow 10.0.0.0/8;
deny all;
или:
if (! str_starts_with($request->ip(), '10.')) {
    abort(403);
}
Смысл схемы:
если запрос пришёл из внутренней сети — значит ему можно доверять.
Проблема в том, что IP-адрес не является identity.
IP показывает только:
- откуда пришёл пакет;
- через какую сеть он прошёл.
Но IP не доказывает:
- какой именно сервис делает запрос;
- имеет ли он право выполнять действие;
- не был ли сервис скомпрометирован.
Почему IP-based security ломается
В современной инфраструктуре:
- контейнеры создаются динамически;
- IP постоянно меняются;
- сервисы масштабируются горизонтально;
- ingress/controller может проксировать запросы;
- internal requests идут через service mesh.
Дополнительно:
- SSRF внутри инфраструктуры обходит IP restrictions;
- compromised pod получает доступ ко всем внутренним endpoint’ам;
- staging environment часто находится в той же сети;
- VPN не гарантирует безопасность сервиса.
IP filtering — это дополнительный слой защиты.
Но не механизм авторизации.
Доверие только внутренней сети
Очень опасный паттерн:
internal endpoint не требует авторизации
Потому что:
- endpoint не опубликован наружу;
- route скрыт;
- сервис «внутренний».
Например:
Route::post('/internal/balance/update');
без:
- middleware;
- authentication;
- signature verification;
- scopes.
Это превращает internal API в скрытый публичный API.
Как только злоумышленник получает доступ:
- к одному контейнеру;
- к SSRF;
- к VPN;
- к bastion-host;
- к CI runner;
- к staging;
он получает доступ ко всей внутренней инфраструктуре.
Передача пользовательского JWT между сервисами
Следующий спорный подход:
Frontend → Gateway → Orders → Billing → Notifications
И пользовательский JWT прокидывается через все сервисы.
На первый взгляд идея кажется логичной:
- пользователь уже авторизован;
- JWT уже существует;
- можно использовать его везде.
Но здесь смешиваются две разные модели identity:
- user identity;
- service identity.
JWT пользователя не отвечает на вопрос:
Какой сервис вызывает endpoint?
Он отвечает только на вопрос:
Какой пользователь инициировал действие?
В итоге:
- сервисы начинают доверять пользовательскому токену;
- backend authorization становится неявной;
- scopes пользователя смешиваются со scopes сервисов;
- появляется риск confused deputy problem.
Отсутствие подписи запроса
Многие системы ограничиваются проверкой:
Authorization: Bearer token
Но bearer token защищает только доступ.
Он не защищает:
- тело запроса;
- query параметры;
- replay attack;
- повторную отправку;
- изменение payload внутри инфраструктуры.
Для критичных операций этого недостаточно.
Например:
{
  "amount": 1000
}
может превратиться в:
{
  "amount": 100000
}
Если нет:
- signature;
- body hash;
- nonce;
- timestamp verification.
Bearer token не гарантирует целостность запроса.
Главная мысль
Большинство insecure internal API строятся вокруг одной идеи:
внутри инфраструктуры все друг другу доверяют
Современная production-инфраструктура должна строиться наоборот:
каждый сервис обязан постоянно подтверждать свою identity и права
Именно вокруг этой идеи дальше строятся:
- per-service credentials;
- scopes;
- request signing;
- OAuth2 Client Credentials;
- mTLS;
- Zero Trust architecture.
Модель угроз
Перед выбором механизма авторизации нужно определить:
От чего именно мы защищаемся?
Без threat modeling большинство систем приходят либо к недостаточной защите, либо к бессмысленно сложной архитектуре.
Service-to-service авторизация должна учитывать не только внешние атаки, но и внутренние компрометации инфраструктуры.
Подмена вызывающего сервиса
Главный риск:
сервис притворяется другим сервисом
Например:
Analytics Serviceвыдаёт себя заOrders Service;- compromised pod отправляет internal requests;
- злоумышленник использует утёкший token.
Если backend не умеет проверять identity сервиса — любая внутренняя система становится доверенной по умолчанию.
Replay attack
Даже валидный запрос может быть опасен.
Например:
POST /internal/payments/charge
с payload:
{
  "payment_id": 100,
  "amount": 5000
}
Если запрос можно повторно воспроизвести:
- произойдёт повторное списание;
- повторная выдача бонусов;
- повторная отправка webhook;
- повторное изменение состояния.
Bearer token не защищает от replay attack.
Для этого нужны:
- nonce;
- timestamp;
- request signature;
- idempotency.
Компрометация одного сервиса
Очень частая ошибка:
если сервис trusted — ему можно всё
Но в реальности:
- любой сервис может содержать RCE;
- любой контейнер может быть скомпрометирован;
- любой dependency может иметь supply-chain vulnerability.
Поэтому:
compromised service != compromised platform
должно быть обязательным архитектурным правилом.
Для этого нужны:
- per-service credentials;
- scopes;
- least privilege;
- audit logging.
SSRF внутри инфраструктуры
SSRF давно перестал быть проблемой только публичных API.
Если сервис умеет выполнять HTTP requests:
- webhook fetching;
- image downloading;
- metadata parsing;
- URL previews;
- PDF rendering;
- OpenGraph fetching;
- external integrations;
то SSRF может стать точкой входа во внутреннюю инфраструктуру.
Если internal API доверяет только внутренней сети — SSRF автоматически получает доступ ко всем сервисам.
Утечка токена
Секреты утекают постоянно:
- через логи;
- через Sentry;
- через debug output;
- через CI artifacts;
- через screenshots;
- через
.env; - через compromised developers machines.
Поэтому любой токен должен рассматриваться как временный секрет.
Архитектура обязана предусматривать:
- ротацию;
- отзыв;
- аудит использования;
- ограничение scopes;
- expiration.
Lateral movement внутри инфраструктуры
После компрометации одного сервиса злоумышленник почти всегда пытается:
- исследовать internal network;
- получить доступ к другим сервисам;
- расширить привилегии;
- найти admin/internal endpoint’ы.
Если сервисы доверяют друг другу без проверки identity — lateral movement становится тривиальным.
Zero Trust архитектура пытается решить именно эту проблему.
Подход 1: Static API Token
Самый простой и самый распространённый вариант.
Сервисы используют общий секрет:
INTERNAL_API_TOKEN=super-secret-token
Клиент отправляет:
Authorization: Bearer super-secret-token
Laravel middleware проверяет значение:
if ($request->bearerToken() !== config('services.internal.token')) {
    abort(401);
}
Почему этот подход всё ещё используют
Причины понятны:
- внедряется за 10 минут;
- не требует отдельной таблицы;
- подходит для MVP;
- минимальный overhead;
- легко отлаживать.
Для:
- 2–3 сервисов;
- dev environment;
- pet-project;
- временной интеграции;
этого действительно может быть достаточно.
Основные проблемы
Но у схемы фундаментальные ограничения.
Нет service identity
Backend не знает:
- кто именно сделал запрос;
- какой сервис скомпрометирован;
- какой сервис создаёт нагрузку.
Нет разграничения прав
Любой сервис получает одинаковые права.
Невозможно реализовать:
- read-only сервисы;
- admin-only операции;
- ограничение privileged endpoint’ов.
Сложная ротация
Один токен используется везде.
Замена секрета требует:
- coordinated deploy;
- синхронного обновления конфигов;
- rollback strategy.
Single point of failure
Компрометация токена = компрометация всей инфраструктуры.
Когда подход допустим
Только если:
- сервисов мало;
- нет критичных операций;
- инфраструктура простая;
- архитектура временная;
- есть понимание ограничений.
Static token — это не production-ready модель для зрелой микросервисной платформы.
Подход 2: Per-service API keys
Следующий уровень зрелости:
каждый сервис имеет собственную identity
Например:
| Service | API Key |
|---|---|
| Orders | ord_xxx |
| Billing | bill_xxx |
| Notifications | notif_xxx |
| Analytics | an_xxx |
Теперь backend умеет определять:
- кто вызывает endpoint;
- какие действия разрешены;
- кто злоупотребляет API;
- какой сервис скомпрометирован.
Структура таблицы
Например:
service_clients
| Поле | Назначение |
|---|---|
| id | идентификатор |
| name | имя сервиса |
| token_hash | hash токена |
| scopes | список разрешений |
| is_active | активен ли ключ |
| last_used_at | последнее использование |
| expires_at | срок жизни |
Почему нельзя хранить raw token
Плохой вариант:
token = super-secret-token
в базе.
Правильнее:
hash('sha256', $token)
Причина та же, что и с паролями:
- база может утечь;
- дамп может попасть в backup;
- доступ к БД ≠ доступ ко всем сервисам.
Middleware авторизации
Пример Laravel middleware:
class AuthenticateServiceRequest
{
    public function handle(Request $request, Closure $next): mixed
    {
        $token = $request->bearerToken();

        if ($token === null) {
            abort(401);
        }

        $serviceClient = ServiceClient::query()
            ->where('token_hash', hash('sha256', $token))
            ->first();

        if ($serviceClient === null || ! $serviceClient->is_active) {
            abort(401);
        }

        $request->attributes->set('serviceClient', $serviceClient);

        return $next($request);
    }
}
Что это даёт
Появляется:
- service identity;
- revoke конкретного сервиса;
- audit logging;
- scopes;
- безопасная ротация;
- least privilege.
Это уже production-grade foundation для большинства Laravel-проектов.
Подход 3: Scopes и permissions
Сам факт авторизации сервиса ещё не означает право выполнять действие.
Правильная модель выглядит так:
authenticated != authorized
Например:
| Service | Разрешения |
|---|---|
| Orders | payments.create |
| Billing | balance.write |
| Notifications | notifications.send |
| Analytics | reports.read |
Почему scopes обязательны
Без scopes любой сервис после авторизации получает полный доступ ко всей инфраструктуре.
Это приводит к:
- privilege escalation;
- lateral movement;
- нарушению isolation.
Middleware scopes
Пример:
Route::post(
    '/internal/payments/create',
    CreatePaymentController::class
)->middleware([
    AuthenticateServiceRequest::class,
    EnsureServiceHasScope::class . ':payments.create',
]);
Middleware:
class EnsureServiceHasScope
{
    public function handle(Request $request, Closure $next, string $scope): mixed
    {
        $serviceClient = $request->attributes->get('serviceClient');

        if (! in_array($scope, $serviceClient->scopes, true)) {
            abort(403);
        }

        return $next($request);
    }
}
Granular authorization
Scopes позволяют:
- отделить read от write;
- ограничить admin actions;
- изолировать billing API;
- делать read-only integrations;
- ограничивать blast radius при компрометации.
Это один из самых важных элементов Zero Trust модели.
Подход 4: Подписанные запросы
Bearer token решает только authentication.
Но не защищает:
- body;
- query params;
- replay attack;
- tampering.
Поэтому для критичных операций используют request signing.
Общая схема
Клиент отправляет:
X-Service-Name: orders
X-Timestamp: 1710000000
X-Nonce: 4f8d2c
X-Signature: abc123
Подпись строится из:
- HTTP method;
- path;
- timestamp;
- nonce;
- body hash.
Например:
POST:/internal/payments/create:1710000000:4f8d2c:body_hash
И затем:
hash_hmac('sha256', $payload, $secret)
Что это даёт
Теперь backend может проверить:
- запрос отправил настоящий сервис;
- body не изменялся;
- request не подделан;
- replay attack невозможен.
Почему это важно
Особенно критично для:
- платежей;
- списаний;
- изменения баланса;
- webhook’ов;
- privileged operations.
Signed requests сильно уменьшают риск:
- request tampering;
- replay attack;
- internal MITM.
Replay protection
Даже signed request можно повторно воспроизвести.
Поэтому обычно добавляют:
- timestamp;
- nonce;
- expiration window.
Timestamp verification
Например:
if (abs(time() - $timestamp) > 60) {
    abort(401);
}
Запрос старше 60 секунд считается невалидным.
Nonce verification
Nonce хранится в Redis:
$cacheKey = 'nonce:' . $nonce;

if (Redis::exists($cacheKey)) {
    abort(401);
}

Redis::setex($cacheKey, 60, 1);
Повторный запрос с тем же nonce будет отклонён.
Timestamp без nonce недостаточен
Если злоумышленник перехватит запрос в пределах временного окна — его всё ещё можно повторить.
Поэтому:
timestamp + nonce
должны использоваться вместе.
Подход 5: OAuth2 Client Credentials
Когда сервисов становится много, shared secrets начинают плохо масштабироваться.
Тогда появляется отдельный authorization server.
OAuth2 Client Credentials flow решает именно service-to-service authentication.
Как это работает
Сервис получает access token:
POST /oauth/token
с:
client_id
client_secret
Authorization server выдаёт:
{
  "access_token": "...",
  "expires_in": 3600
}
И сервис использует его для internal API.
Преимущества
- централизованная identity;
- expiration token’ов;
- scopes;
- revoke;
- audit;
- standard approach.
Недостатки
- сложнее инфраструктура;
- появляется auth-service;
- нужен token lifecycle management;
- больше operational complexity.
Для маленьких проектов OAuth2 может быть overengineering.
Но для большой микросервисной платформы — это уже стандарт.
Подход 6: mTLS
mTLS — mutual TLS.
Сервисы аутентифицируют друг друга сертификатами.
Не только сервер доказывает identity клиенту.
Клиент тоже доказывает identity серверу.
Как это выглядит
Каждый сервис получает:
- client certificate;
- private key;
- trusted CA.
Во время TLS handshake сервисы взаимно подтверждают identity.
Плюсы
- сильная transport-level authentication;
- отсутствие shared tokens;
- хорошо интегрируется с service mesh;
- сложно подделать identity.
Минусы
- высокая operational complexity;
- certificate lifecycle management;
- rotation certificates;
- сложная отладка;
- нужен зрелый DevOps.
mTLS хорошо работает:
- в Kubernetes;
- в service mesh;
- в enterprise инфраструктуре.
Но даже mTLS не заменяет scopes и business authorization.
Практическая архитектура для Laravel
Production-ready схема обычно выглядит так:
Service
    ↓
API Key / OAuth Token
    ↓
Authentication Middleware
    ↓
Scope Middleware
    ↓
Signature Verification
    ↓
Business Logic
Базовые компоненты
app/
  Modules/
    ServiceAuth/
      Domain/
        Services/
          ServiceAuthenticator.php
          ServicePermissionChecker.php
          SignatureVerifier.php
      Infrastructure/
        Http/
          Middleware/
            AuthenticateServiceRequest.php
            EnsureServiceHasScope.php
            VerifyServiceSignature.php
ServiceAuthenticator
Отвечает за:
- поиск service client;
- проверку token hash;
- проверку expiration;
- проверку active state.
SignatureVerifier
Проверяет:
- body hash;
- timestamp;
- nonce;
- request signature.
Audit logging
Каждый internal request желательно логировать.
Минимум:
- service name;
- endpoint;
- method;
- status;
- correlation id;
- execution time;
- failure reason.
Но:
- не логировать raw tokens;
- не логировать signatures;
- не логировать secrets.
Ротация ключей
Секреты обязаны ротироваться.
Production architecture должна это поддерживать изначально.
Типичная схема
У сервиса одновременно существуют:
- current key;
- next key.
Во время rollout backend принимает оба ключа.
После завершения rollout старый ключ удаляется.
Что важно
Ротация не должна:
- ломать production;
- требовать downtime;
- требовать мгновенного synchronized deploy.
Дополнительно полезно
- expiration;
- usage monitoring;
- alerts на использование старых ключей;
- forced revoke.
Типичные ошибки проектирования
Один токен на всё
Самая частая и самая опасная ошибка.
Internal API без authentication
“Это же internal endpoint”.
Обычно заканчивается плохо.
Отсутствие scopes
Authentication без authorization.
Нет replay protection
Критичные операции становятся повторяемыми.
Нет audit log
После инцидента невозможно понять:
- кто делал запрос;
- что произошло;
- какой сервис скомпрометирован.
Токены живут годами
Любой долгоживущий секрет рано или поздно утечёт.
Internal endpoints доступны извне
Очень частая проблема:
- debug routes;
- forgotten nginx config;
- staging exposure;
- ingress misconfiguration.
Internal endpoint должен считаться hostile по умолчанию.
Минимальный production-ready вариант
Для большинства Laravel-систем достаточно следующей схемы:
- HTTPS;
- per-service API keys;
- hash токенов в базе;
- scopes;
- middleware authentication;
- audit logging;
- key rotation;
- timestamp + nonce для критичных endpoint’ов.
Это уже даёт:
- service identity;
- least privilege;
- revoke;
- replay protection;
- auditability.
Без чрезмерной сложности.
Когда что выбирать
| Система | Подход |
|---|---|
| 2–3 сервиса | API keys + scopes |
| Платежи | signed requests + nonce |
| Большая платформа | OAuth2 Client Credentials |
| Kubernetes + service mesh | mTLS |
| Enterprise Zero Trust | mTLS + OAuth2 + policy engine |
Финальный вывод
Service-to-service авторизация — это отдельный слой безопасности.
Её нельзя заменять:
- internal network;
- VPN;
- Docker network;
- Kubernetes cluster;
- shared API token.
Современная архитектура должна исходить из модели:
внутренние сервисы не являются trusted по умолчанию
Каждый сервис обязан:
- подтверждать identity;
- иметь ограниченные permissions;
- проходить audit;
- иметь возможность revoke;
- работать по least privilege.
Для большинства Laravel-проектов production-ready минимум выглядит так:
- отдельный token на сервис;
- scopes;
- audit log;
- ротация;
- signed requests для критичных операций;
- replay protection.
Именно это превращает internal API из «набора скрытых endpoint’ов» в полноценную безопасную backend-инфраструктуру.